#InfoQ推荐
最近,超维动力宣布完成超 5 亿元天使+轮系列融资。随着融资消息的公布,创始团队也正式亮相。创始团队包括原华为自动驾驶业务高管喻杰、香港大学教授罗平,以及机器人连续创业者郑存远。此次投资方包括祥峰资本、方广资本、万石资本等,资金将用于基座模型研发、具身应用落地和行业生态拓展。
2025 年 7 月成立以来,超维动力的研发和业务已覆盖数据、模型、本体和基础设施等多个环节。目前形成的产品矩阵包括第一人称数据采集设备 KAI Halo、KAI World Model、具身智能 AI Infra、高拟人人形机器人 KAIBot,以及高自由度灵巧手 KAI Hand。其中,KAI Hand、KAI Halo Lite 已经全球开售,并向产业客户交付。
这种全栈能力,也是本轮投资人关注超维动力的重要原因。
祥峰投资执行合伙人李伟表示:“具身智能的实现路径至今没有收敛。当数据、模型与本体分开推进时,问题出在哪一层都难以判断。在这样的阶段,我们更看重那些有能力定义全栈标准的团队。”
祥峰资本在机器人上的出手一向早于行业热潮。2017 年国内资本对机器人关注有限时,祥峰就领投了仓储机器人极智嘉 A+ 轮;2020 年,它又成为宇树科技 Pre-A+ 轮唯一机构投资人,并在后续轮次持续加注。过去十年,在机器人领域,祥峰陆续投资了精锋医疗、松灵机器人、松延动力等明星公司,覆盖仓储、医疗、移动机器人和人形机器人等场景和领域。
全栈路线的价值,也体现在不同技术环节能够协同设计。超维动力联合创始人罗平认为,本体决定机器人的动作空间、感知能力和任务上限,数据影响模型的泛化能力,模型在真实任务中的反馈,又会推动硬件和数据采集继续迭代。
超维动力的团队背景,保障了全栈系统的实现。
超维动力联合创始人兼 CEO 喻杰,前华为 22 级自动驾驶产业高管,主导华为超大规模 AI Infra 落地,经历了自动驾驶从零到百万辆以上量产的过程。第二位联合创始人罗平,是香港大学计算与数据科学学院教授、副院长,谷歌学术引用超 10 万次,H 因子 110+。第三位联合创始人郑存远,是中美机器人与智能硬件领域连续创业者,知名机器人公司整机研发负责人。
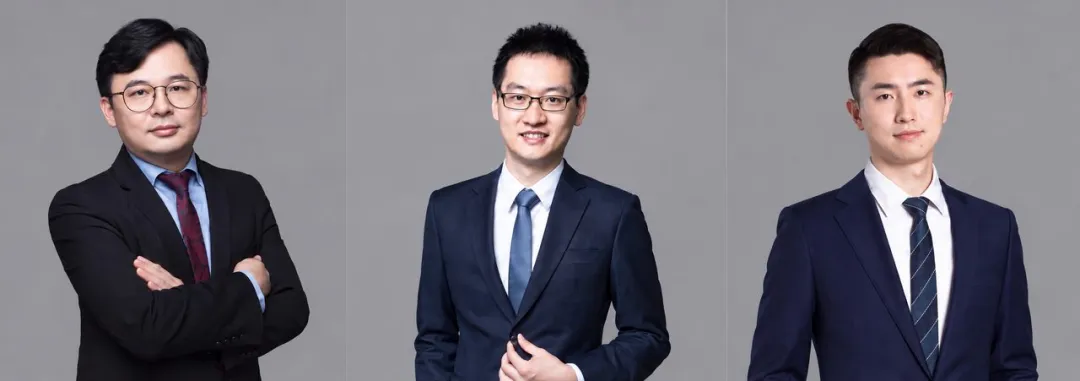
备注:从左到右,分别是喻杰、罗平、郑存远
三个人分别带来了复杂系统量产落地、模型算法和机器人本体能力。这也构成了超维动力同时向数据、模型、本体多个环节推进的基础。
过去一年,超维动力的技术路径也充分体现了这种全栈路径:依托 KAI Halo 拓宽人类数据的采集边界,凭借高度拟人的 KAIBot 降低人类动作向机器人的迁移损耗;KAI World Model、SMASH 等模型和系统,则进一步探索如何实现跨任务、跨本体泛化。
# 构建以 Ego 为主的数据金字塔,打破 Scaling 瓶颈
相信数据规模以及模型尺寸的提升,会带来具身智能能力的提升,这就是具身智能的 Scaling Law。
因此,如何大规模、低成本、高质量地获取数据,就成为具身数据领域的关键问题。
机器人本体数据很难低成本、大规模获取。根据 InfoQ 与业内人士的交流,一般的机器人本体配合数采员工,每天稳定工作的时间不超过 10 小时,其中有效数据占比大约只有 1/3。整体管理、采购和数据处理成本较高,每小时千元是常态。
与此同时,机器人本体还会因过热、损坏等问题出现宕机和维修,机器人更新换代也会带来折旧。真机采集还涉及不同本体之间的异构问题。这一切都使真机数据的获取成本过高、难度过大。
过去一年,Ego Data(注:“主观第一人称视角”的多模态人类经验数据)已经成为行业扩大数据供给的重要方向。
超维动力也把第一人称数据放在了模型训练的重要位置。这背后的考量是,人本身就是规模巨大、能力丰富的数据来源。
相比普通互联网视频,第一人称数据更接近机器人未来真正面对的任务视角。人在做饭、整理物品、操作工具时,摄像头跟随身体移动,可以连续记录人在什么环境下看到了什么、做出了什么动作,以及动作之后环境发生了什么变化。
相比依赖机器人和遥操作设备采集真机数据,让人直接进入真实工作和生活场景,也可以把数据采集扩展到更多任务和环境。
为此,超维动力推出了 KAI Halo。
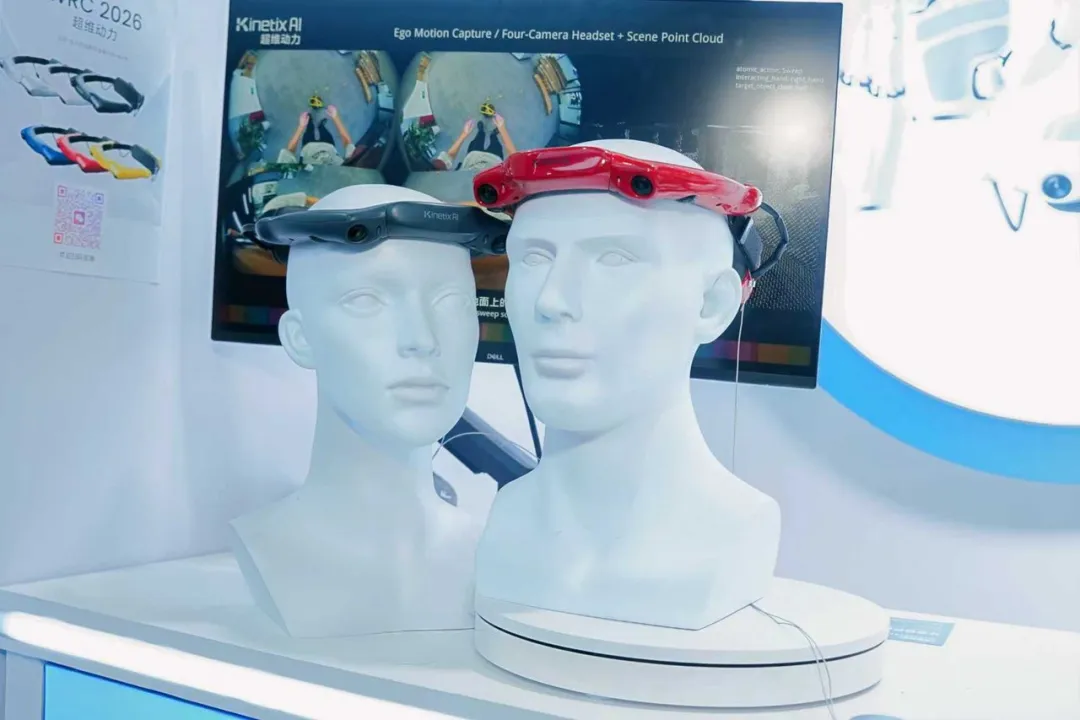
KAI Halo 采用轻量化头环形态,由人直接佩戴。在记录第一人称视频之外,它还可以通过纯视觉完成人体姿态和场景点云重建,并加入语义标注。人在真实环境中的自然操作,由此可以进一步转化为模型训练所需的数据。
目前,超维动力已经通过众包方式,将 KAI Halo 部署到家庭、酒店等 20 多种场景,累计采集 10 万小时第一人称数据。
采集到足够多的数据只是第一步,数据处理也是一个大问题——如此大规模的数据,不可能继续依赖人工审核和处理。
超维动力为此搭建了 KAI AI Infra 平台。采集的数据进入平台后,首先自动筛选关节丢失、运动轨迹异常等问题;通过筛选的数据再经过动作重定向,映射到机器人的运动空间;最后根据不同训练目标调整数据比例,形成对应的数据集。
比如面向酒店场景训练时,就可以提高酒店数据在数据集中的比例。设备分发、数据采集、质量筛选、Retargeting、数据集创建再到模型训练,由此形成一条自动化的数据管线。
有了大规模 Ego 数据,下一个问题是怎么把人的动作迁移到机器人上。
如果人的身体和机器人的身体相差太远,采集再多 Ego 数据,也会付出高昂的转换成本。 这也是为什么超维动力在扩大 Ego 数据的同时,还要做一台高度拟人的机器人。
# 打造高拟人本体,让本体成为人类数据的“低损耗载体”
当具身智能越来越多地从人类数据中寻求 Scaling 的可能,本体和数据的协同设计也变得更加重要。
人与机器人的身体结构差异越大,动作重定向(Retargeting)就越困难。以伸手、下蹲或转身为例,如果机器人的身体比例、关节位置和活动范围与人类相差悬殊,系统就需要对人的动作进行更多调整,部分原始运动信息也可能在转换中丢失。
因此,超维动力在研发 KAIBot 时,一个重要目标就是降低人类数据向机器人迁移时的损耗。
罗平在接受“42 号电波”采访时表示,单纯追求外形拟人并非超维的最终目的。“承载人类数据才是我们的核心目标。”他进一步解释,“跟平均人的身高和体格接近的本体,承载人的动作数据是最好的,因为做 Retargeting 时失真更少。”
这首先体现在身体比例上。
KAIBot 身高约 173 厘米、体重约 70 公斤,头身比约 1:8.5,整体尺寸接近成年人。手臂长度、腿长、躯干比例以及末端可达的工作空间越接近人,人类伸手取物、弯腰、下蹲等动作迁移到机器人时,需要进行的调整就越少。
但身体尺寸接近还不够。机器人还需要覆盖接近人类的“运动空间”。
KAIBot 全身拥有 117 个自由度,肩部、颈部、腰部等关节都按照人体形态进行设计。更多与人体对应的关节,让机器人能够覆盖更完整的人类运动空间。
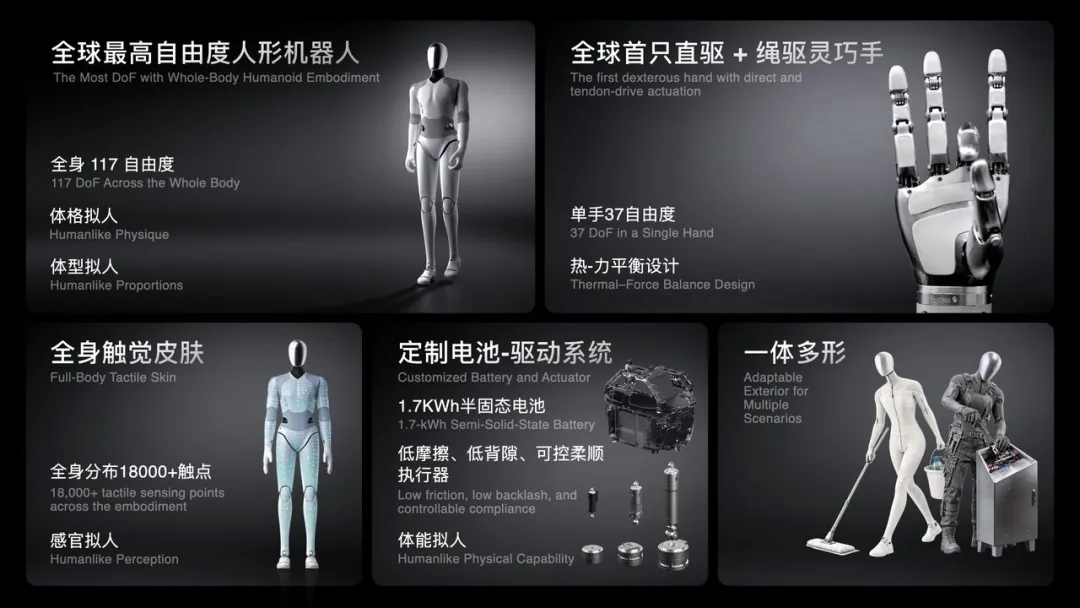
这些关节直接影响人类动作数据在迁移时能够保留多少细节。
人伸手拿远处的物体时,很少只有手臂单独运动。肩部会参与运动,躯干会旋转或侧倾,腿部调整支撑,头颈也会随目标改变姿态。如果机器人缺少对应的关节,Retargeting 就需要把这些运动重新分配到其他关节。即使手最终仍然能够到达目标,原本的全身协调关系也可能发生变化。
在移动操作中,这种差异更加明显。弯腰、下蹲、跨步取物、双手搬运,本身就是复杂的全身运动。拥有更多与人体对应的关节,可以让机器人尽可能沿用人类原本的动作结构,减少重新“翻译”动作带来的损耗。
手部设计也同样贯穿拟人原则。
KAI Hand 拥有 20 个主动自由度、1 个被动自由度和 16 个柔顺自由度,指尖力超过 30N。主动自由度负责抓握和工具操作,柔顺自由度则让手部在与外部发生接触时具备一定的顺应能力。它还加入了单向自锁结构,在长时间握持重物时,不需要持续依赖高功率输出维持抓握。
对于 Ego 数据而言,手部结构同样会影响数据迁移。人的抓、捏、握,以及使用工具,都依赖多个手指关节协同。机器人手的尺寸、关节布局和活动方式越接近人手,来自人类的精细操作数据就越容易映射到机器人上。
超维动力还把拟人延伸到了感知。
KAIBot 约 80% 的体表覆盖触觉皮肤,全身拥有约 1.8 万个触点。视觉可以告诉机器人物体在哪里,触觉则补充身体真正发生接触之后的信息。对于抓取、搬运以及人与机器人直接接触的场景,这些信息同样会进入机器人的感知和控制。
从身体比例、关节自由度,到灵巧手和触觉,KAIBot 对拟人的追求已经深入到本体设计的多个层面。对超维动力来说,这些设计最终服务于一个具体目标: 减少人类数据在重定向过程中的失真。
机器人真正进入物理世界后,身体只是行动的基础。面对不断变化的环境,如何理解当前状态、预测动作结果并做出决策,则进入了模型要解决的问题。
# 沉淀通用能力,让模型跨越本体与任务的限制
有了足够的数据和与之匹配的本体,下一个问题是,机器人如何理解世界,并在真实世界中行动。
这也是超维动力选择世界模型路线的原因。联合创始人郑存远曾表示:“我们觉得具身智能背后的真正问题是,机器人是否能够理解世界,并在真实的世界中展开行动。而这一切都指向了一个核心能力,那就是 world model。”
现实世界并非静态。机器人执行动作,也会改变下一刻的环境。因此,模型不仅要生成动作,还要预测动作的结果。
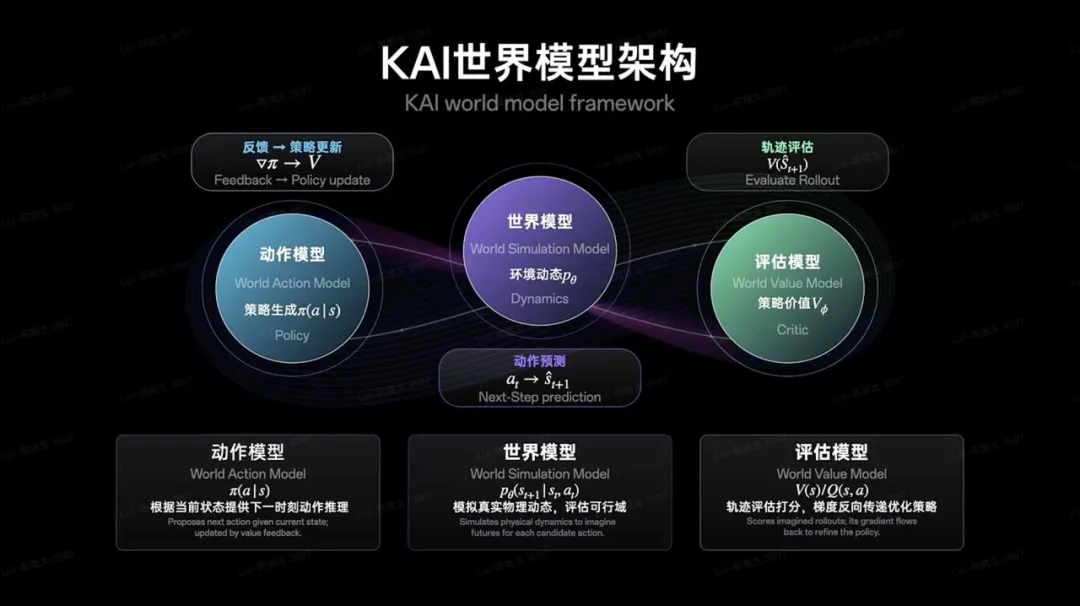
KAI World Model 由世界模型、动作模型和评估模型组成。动作模型生成候选动作,世界模型推演动作带来的状态变化,评估模型再从任务进度、接触安全和本体可行域等维度评价轨迹,最终选择更优策略。
也就是先提出动作,再推演后果,最后做出选择。
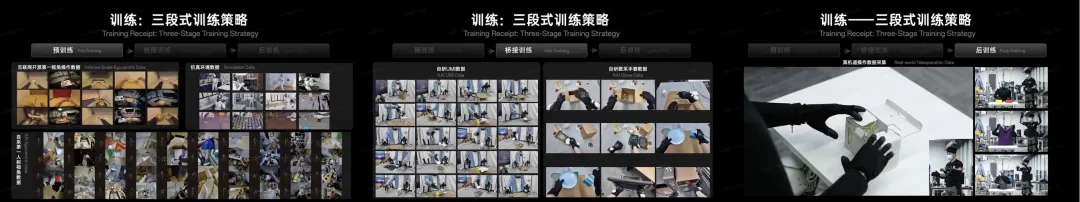
训练上,KAI World Model 采用预训练、桥接训练和后训练三个阶段。
预训练使用互联网开源数据、仿真数据和自采第一人称数据,学习通用常识和全身交互;桥接训练加入 UMI 和数采手套数据,补充预训练数据缺少的物理接触信息,包括手指运动、摩擦力和压力;后训练再用少量真机遥操作数据,解决模型部署到具体机器人时的本体对齐问题。
超维动力没有等待世界模型覆盖所有问题,先通过 SMASH 这样的系统,单独验证高动态 Loco-manipulation 能力。
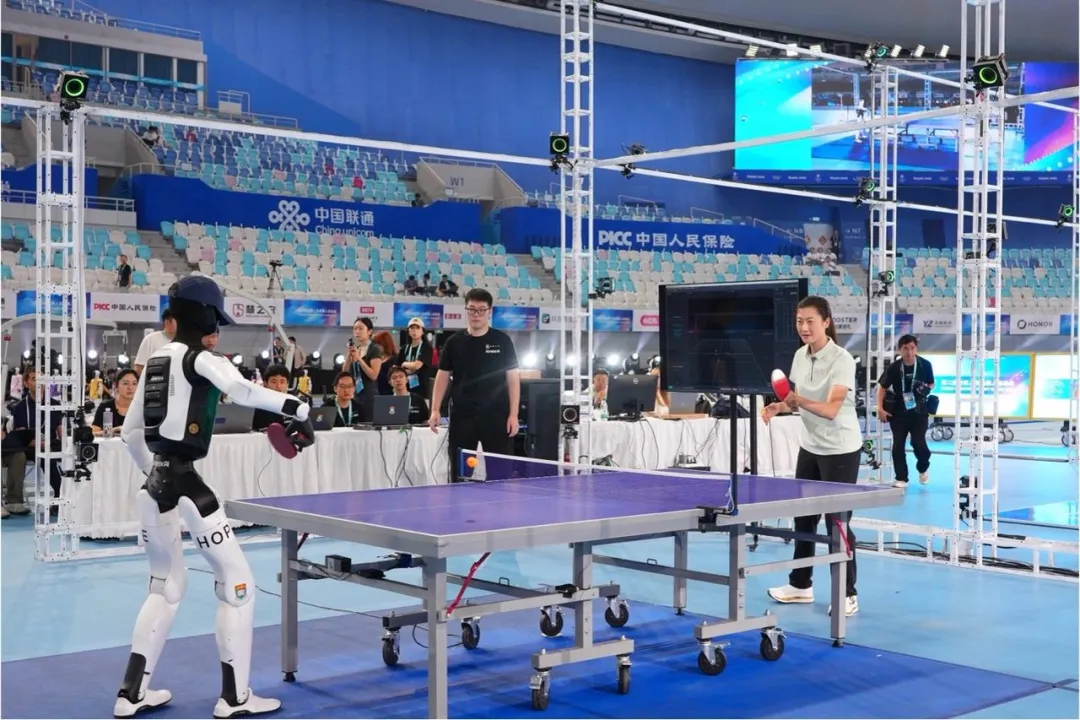
SMASH 系统中,机器人通过腰部第一视角相机观察来球,实时预测轨迹,再调动腿、腰、肩、肘、腕完成移动、重心调整和击球。
第二届世界人形机器人运动会在北京国家速滑馆“冰丝带”举行,在开幕式上,香港大学与超维动力组成的港大超维战队,受邀作为乒乓球比赛的表演队伍与乒乓球世界冠军丁宁进行了表演赛。搭载了 SMASH 系统的机器人在比赛中能左右大幅度移动,可以做出捞球、削球等动作,击球技术表现高度拟人,具有互动和观赏性,丁宁称 SMASH 系统“未来可期”。
SMASH 的核心算法已经在超维动力自己机器人本体 KAIBot、宇树 G1、智元远征 A3 等不同本体上完成适配或部署测试。超维动力也将算法的跨本体能力作为长期提升的方向。
在接受钛媒体采访时,喻杰表示 SMASH 更多是能力检验:“全身协调、感知、预测、控制,要在一个高速动态的任务里对齐,它很考验系统的上限。”
# 结语
从世界模型对未来状态的推演,到 SMASH 在高速交互中完成感知、预测和控制,超维动力的模型探索最终还是回到了郑存远提出的那个问题:机器人如何理解世界,并真正行动于其中。
具身智能的技术路线还没有收敛。数据怎么采、模型怎么训、本体应该采用什么形态,行业仍在探索。
以全栈的方式切入,一个好处是可以从整体上寻找系统解法。数据采集方式、本体形态和模型训练彼此关联:什么样的数据更容易迁移到机器人,会影响本体设计;本体拥有怎样的运动和感知能力,也会影响模型如何训练。
对于投资人来说,在路线尚未收敛的时候,押注某一个技术方案的风险很高。而超维动力给出的回应是:与其押注某一条路线,不如把数据、本体、模型都放在自己手里,让每一层的真实反馈都能驱动其他层迭代。这正是祥峰投资执行合伙人李伟所说的"定义全栈标准"的含义。
祥峰再次出手,超维动力获超 5 亿融资,我们拆解了这家公司的全栈路线 - InfoQ


](https://cdn3.ldstatic.com/original/4X/6/b/0/6b0aba5a040ebaa1d15fd5fd5e6e01e98aab1cdc.jpeg) "image")
14 个帖子 - 10 位参与者
[阅读完整话题](